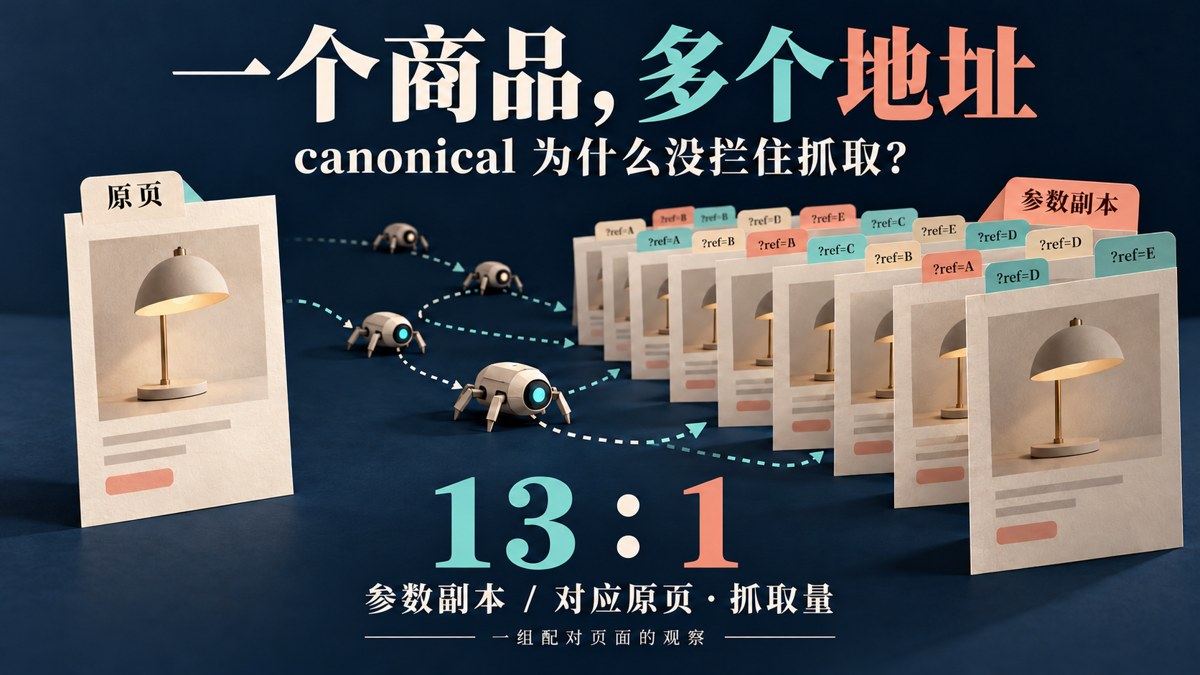
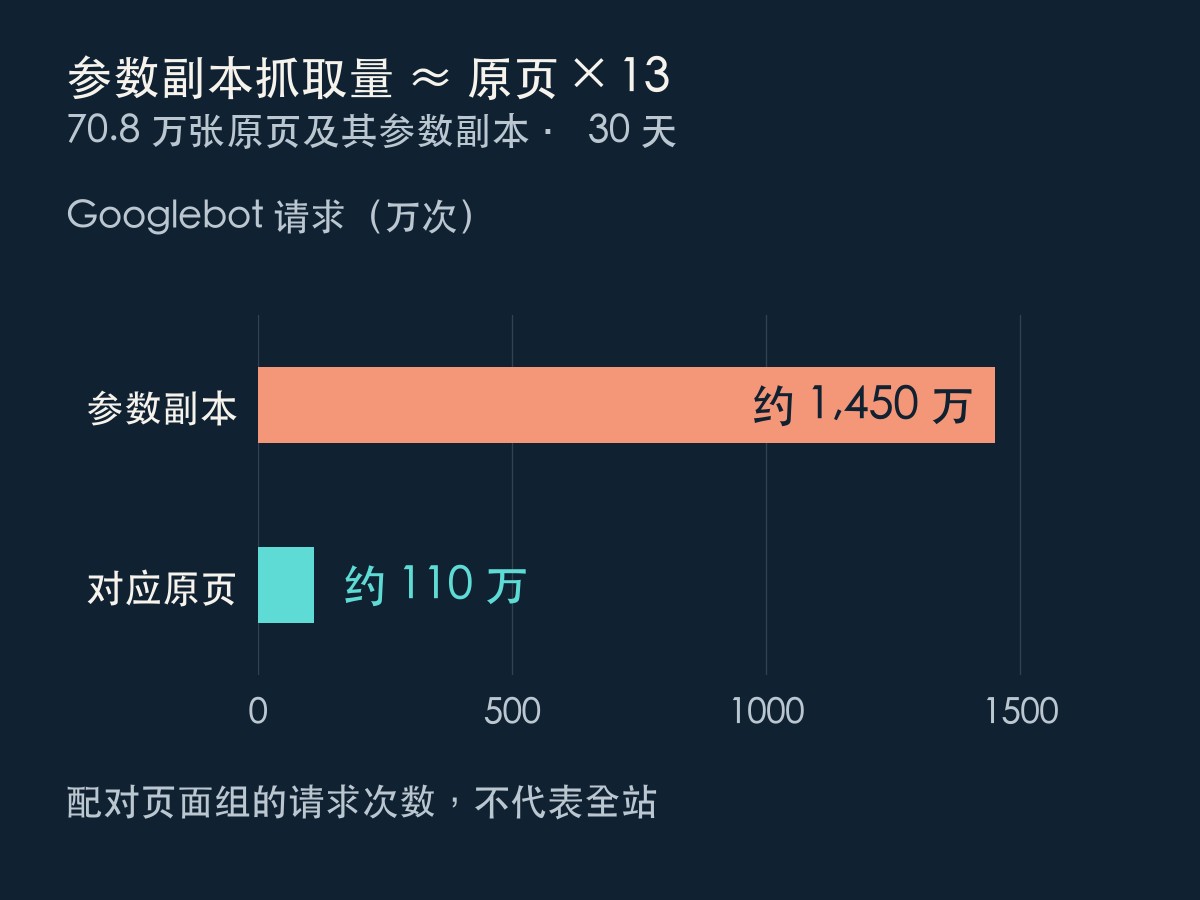
我对照一家大型电商网站的抓取数据时,注意到一组已经对应起来的页面:70.8 万张不带参数的原页,在 30 天里得到约 110 万次 Googlebot 请求;它们的参数副本,得到了约 1,450 万次。
副本得到的请求,约是原页的 13 倍。
这些副本已经配置了指向原页的 canonical。只看这个配置,似乎已经告诉搜索引擎“这是同一份内容”。可请求仍然大量落在不同的参数地址上。为什么会这样?
我会先沿着这些地址往回找,看看是谁在持续生成它们。改一条抓取规则也许能让请求数很快变小,但如果链接每天还在变出新版本,问题就没有完全处理好。
canonical 管的是哪个版本代表页面
同一件商品可能有一个普通链接,也有带广告来源、活动标记或联盟跟踪信息的链接。如果这些地址展示的商品内容相同,canonical 可以向 Google 表明:我希望用哪个网址来代表它们。
但这不会让其他地址立即变成“不要访问”。页面里的 canonical 要能被读取,Google 也有自己的规范网址选择。有这个标签,还不足以让我确认 Google 已经采用它,更不能把它当成抓取禁令。 Google 对规范网址的说明把它列为强信号,而不是强制结果。
所以,眼前的 13 倍并不足以让我认定 canonical 配置失败了。它先说明另一件事:即使已有规范化信号,这批副本仍然获得了大量请求。要解释原因,还得看链接是否持续出现、页面是否真的等价,以及 Google 实际选中了哪个版本。
还有一个数字很容易让人下判断。同一个 30 天窗口里,归到参数 URL 名下的搜索点击约 5,000 次,占约 310 万次点击的 0.16%。把它和抓取量并排看,很容易得出“耗费这么多请求,却几乎没有回报”。
我不会这样算。Search Console 的数据归属规则通常把不同版本的点击和曝光记到 Google 选定的规范网址上,个别情况例外。参数 URL 名下点击很少,可能与这种归属方式有关;它也没有告诉我广告、联盟链接带来了多少访问或订单。
这不妨碍我调查重复抓取,但调查的理由需要站得住:同一份内容是否被反复换成新地址、重要商品的更新是否受到影响,而不是把两种口径的数字除一下,就宣布这些链接没有价值。
我会沿着这些地址,往生成它们的地方找
把全站请求按参数来源拆开后,一个方向很突出:Shopping 相关链接对应了约 62.7% 的 Googlebot 请求。这里的分母是全站请求,不是前面那组配对页面,也不是仅有参数的请求。
这个占比让我愿意先检查商品数据源里的链接模板。相关链接里出现了没有替换成实际值的跟踪占位符;另一类联盟链接则通过不同标记,产生了大量首页地址版本。面对这种情况,逐个清理 URL 很难跟上,生成规则才是更值得检查的地方。
我想先看一件具体商品从数据源到落地页的过程:商品数据源提交的是什么地址,活动链接又加了什么,经过跳转后到了哪里,页面是否还会继续输出带参数的内链。这样才能判断,一个新地址到底是商品发生了变化,还是跟踪信息变了。
这一步会直接影响修法。如果参数决定的是型号、颜色或市场价格,去掉它可能让用户看到另一个商品状态;如果它只是记下来源,也要确认删除或跳转之后,广告归因和联盟结算还能正常工作。我想减少的是不必要的地址变化,不能顺手丢掉链接原本承担的功能。
robots.txt 也值得查,但有一个时间差不能略过。10 月 8 日检查到的配置,在宽泛的参数禁抓规则之外,又给部分跟踪参数开了更具体的放行规则。按 Google 的规则匹配方式,匹配到的更具体规则可以生效,不能只看见一条 Disallow 就认为已经挡住了所有参数。
不过,抓取数据来自八月至九月,配置检查发生在十月。要说这组规则造成了此前的大量请求,我还需要查当时的版本。它足够支持现在去核实,却不能单凭十月看到的配置解释过去。
改规则之前,先让一组链接走通
如果由我安排这次修复,我会从 Shopping 相关链接里,选一组已经确认只改变跟踪信息、不改变商品内容的地址。先让一件商品走完整个访问和归因流程,再考虑扩大到同类模板。
新链接要先稳定下来。商品内容没变,就不应因为模板错误、未填的占位符或不必要的随机标记,持续产生新的可抓取地址。如果必须保留跟踪信息,我会和负责投放、联盟及商品数据源的人一起确认它应该放在哪里,而不是由 SEO 单方面把参数清空。Merchant Center 对落地页和链接字段的要求也需要一起核对。
已经存在的副本,则要看它们今后还需不需要访问。确实要废弃、内容又等价的地址,可以评估直接跳到对应原页;仍需保留访问的地址,继续核实 canonical、站内链接和站点地图是否指向一致。若有副本已经被索引、规范版本也没选对,就需要让 Google 有机会读到合并信号,不能一边指望它处理 canonical,一边先把访问挡住。
等这些关系清楚了,再决定哪些地址长期不需要 Googlebot 抓取,是否适合用 robots.txt 限制。Google 明确提醒,robots.txt 不能代替规范化处理,被禁止抓取的网址仍可能以没有页面内容的形式出现在索引中。
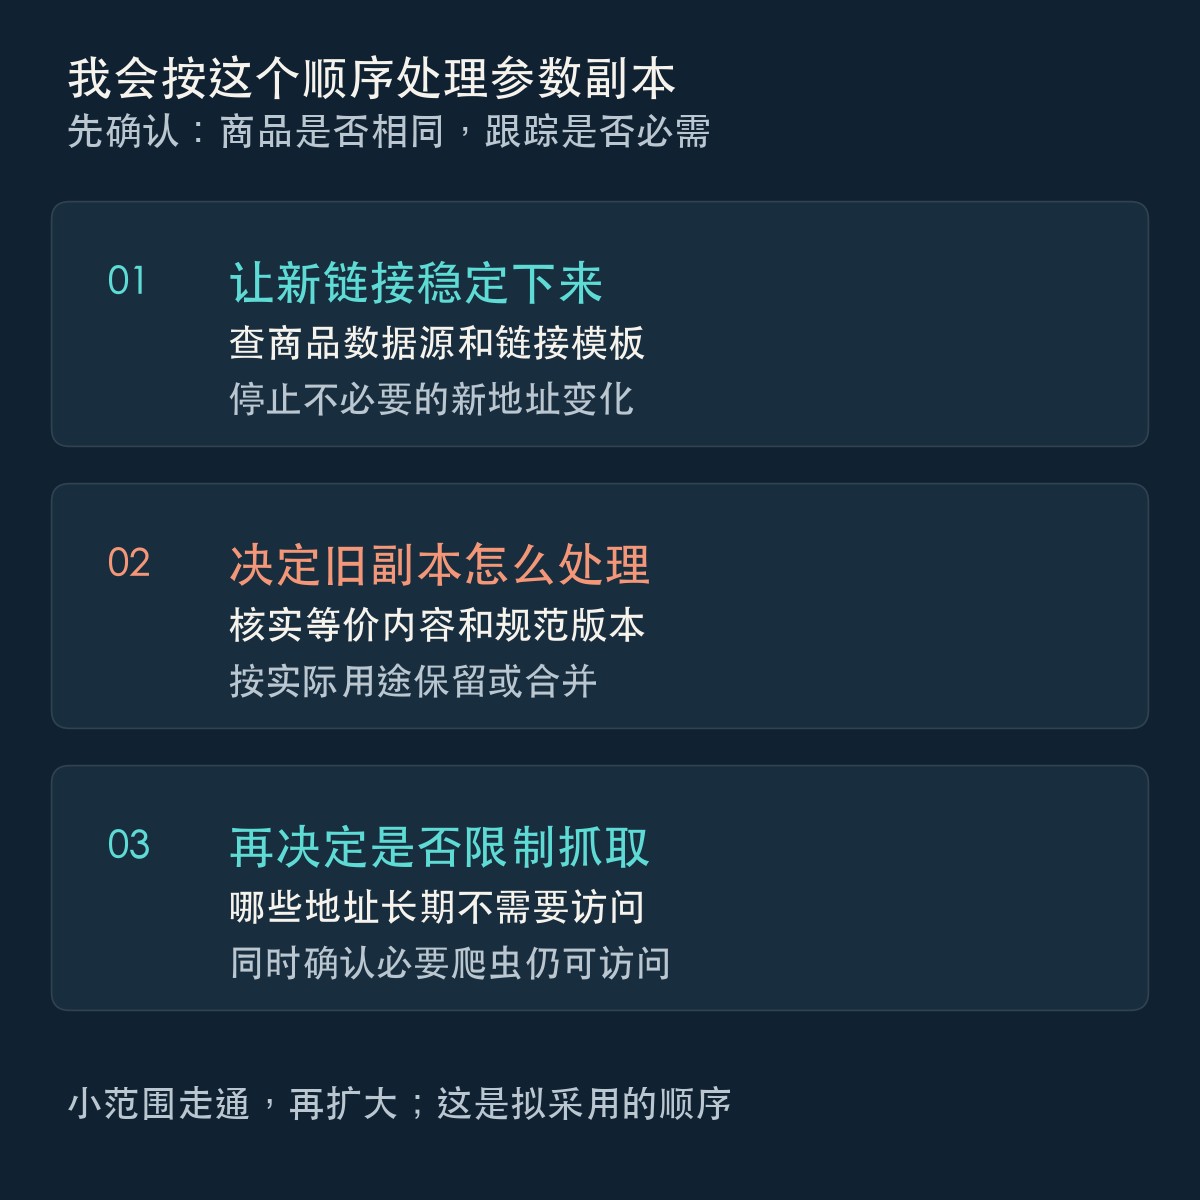
这一组链接跑通之后,我会检查用户到达的商品、价格和库存是否正确,归因是否保留,所需爬虫能否完成访问,再扩大到下一组。广告和商品审核所需的访问,也要逐项验证。
我想看到的,是重要商品信息被及时更新
参数请求减少之后,很容易拿一张下降的曲线宣布修好了。我会继续看原页。
同一日志窗口里,有约 29.8 万张原页没有观察到 Googlebot 请求,它们的参数副本却被请求过。这个反差值得调查,但“30 天没抓原页”并不等于页面没有收录,也不能直接说明商品信息过时了。对于长期没变化的商品,少抓几次未必有问题。
我会从中挑出一批仍在售、价格或库存确实发生过变化的商品,固定页面范围,记录内容更新时间,再看 Googlebot 何时取到了更新后的内容,以及 Google 选定的规范版本是否正确。必要时把原页和已确认等价的副本放在一起看,避免漏掉通过其他地址发生的内容读取。
这能把两件事分开:重复请求是否少了,需要更新的商品信息是否更及时地被获取。只有前者改善,还不足以说明后者也改善了。
Google 的抓取预算说明也提醒,限制一批 URL,并不保证省下来的抓取会转给其他页面;是否已经触及站点的抓取容量上限,会影响这种转移。因此,我不会把约 1,450 万次副本请求当成一笔可以直接分配给商品原页的固定配额。
如果链接源头已经稳定、参数请求下降,而重要商品的更新仍然迟迟没有被获取,我会接着查这些页面的发现路径、服务器响应和更新信号。此时继续扩大封禁范围,未必能回答问题。
我希望修完之后能说清楚的是:哪些重复地址不再被制造,哪些既有副本得到了合适处理,以及真正需要更新的商品有没有被及时读到。至于曝光、点击和订单是否随后改善,还需要分别观察。请求数变小,只是这次工作的一个结果。