在一组电商网站的抓取数据里,我注意到 4,310 万次请求。它们访问的是被归为“干净网址”的地址,却没有匹配到一次站内爬取的页面清单。
这个数字值得单独拿出来看。讨论抓取浪费时,很容易把注意力放在参数网址上,但这里还有一大组地址,光看有没有参数,解释不了它们为什么不在清单里。
同一时期,落在清单内干净网址上的请求只有 470 万次,占全部 Googlebot 请求的 3.2%。这个比例看着很低,可我要判断该改哪里,还得先弄清楚:清单外的那些地址,究竟是什么页面?
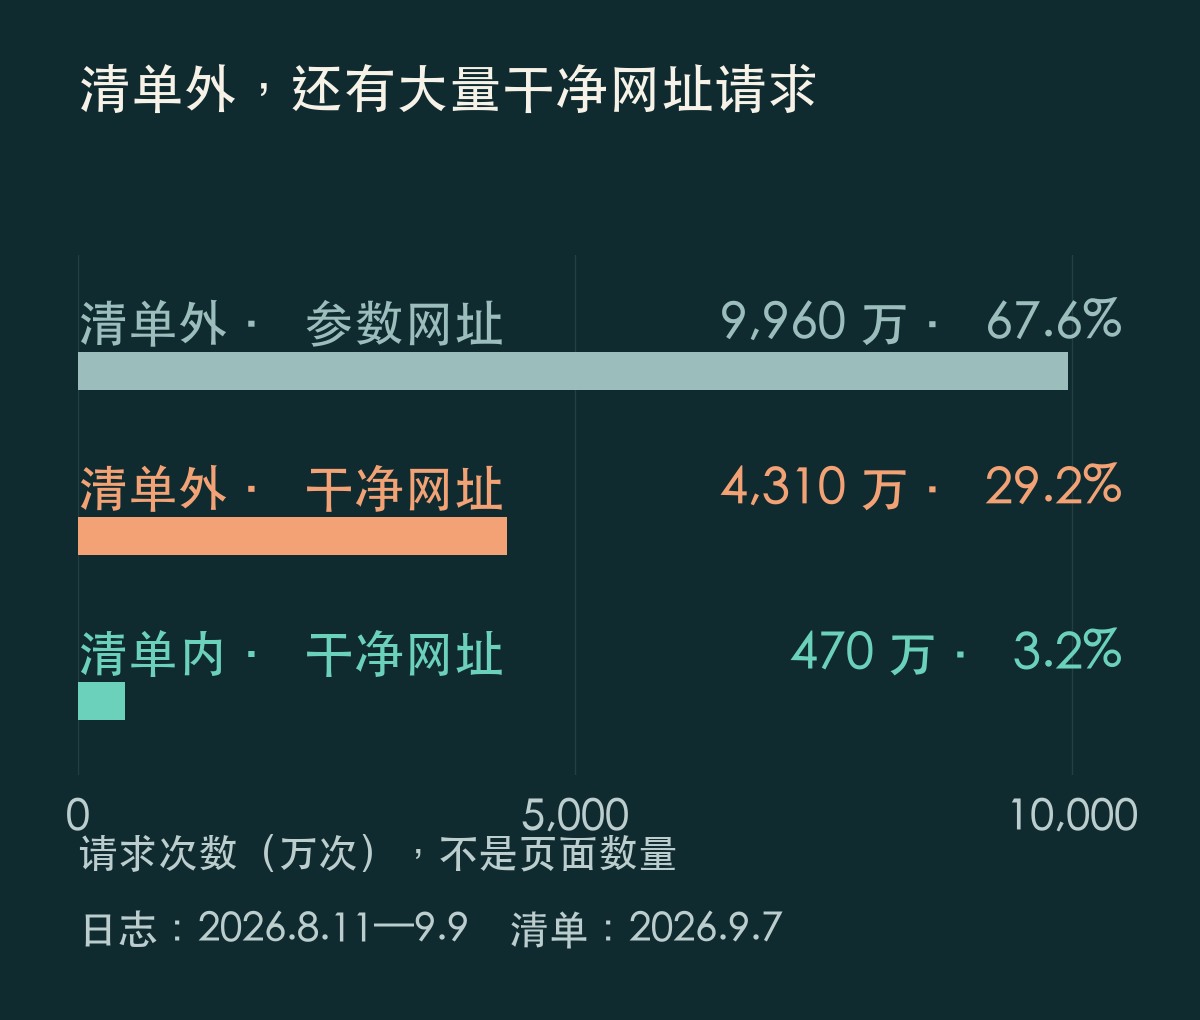
这 4,310 万次请求,先别急着归为浪费
把两组干净网址的请求合起来,是 4,780 万次。其中约 90.2% 落在清单之外。也就是说,即便暂时把参数网址放到一边,两边对不上的部分仍然很大。
但我不能据此说,九成干净页面没有被站内爬虫发现。这里数的是请求:少数地址被反复访问,也可能贡献大量请求。要判断漏掉了多少页面,需要把网址去重,得到另一组数量。
“干净”也只是这次统计中与参数网址相对的分类。一个地址没有参数,里面仍然可能是下架商品、重复内容或跳转。它有没有保留价值,要看页面本身。
因此,3.2% 在这里能说明的,是有多少请求匹配到了这份清单。要把它解释成“有效抓取占比”,还缺一步对页面价值的判断。如果清单外有大量正在销售、内容完整的商品页,处理方向会和大量过期地址完全不同。
我会先把两份清单的边界对齐
日志覆盖了 30 天,站内爬取则发生在 9 月 7 日。两者并没有记录同一段时间里的同一件事。
假设一件商品八月底下架了,Googlebot 在下架前访问过它,9 月 7 日的站内爬取却已经找不到入口。它就可能落入清单之外。反过来,9 月 8 日新上线的页面,也不可能出现在前一天的爬取结果里。这两种情况都需要查上线、下架记录才能确认,单看这张图分不出来。
时间之外,我还会看这次爬取从哪些入口开始,有没有排除某些目录或语言版本,是否碰到了数量上限,是否完整运行结束。这些设置决定了它有机会发现哪些页面。清单里有 200 万个页面,说明规模很大,却不能因此认定已经覆盖全站。
接下来才是网址匹配。有的导出只保留路径,有的带着域名;有的记录原始请求地址,有的记录跳转后的地址。需要先确认两边是在比较同一层面的东西。为了提高匹配率而直接去掉参数、语言路径或末尾斜杠,可能把本来不同的页面合在一起,我会保留原始地址,再逐项核对确实等价的写法。
Google 认识的地址,本来也不只来自这一次站内爬取。Google 对网址发现过程的说明提到,地址可以来自过去的访问记录、页面链接以及提交的 sitemap。今天从站内入口走不到一个地址,并不妨碍 Google 以前就知道它。
查到哪种页面,才决定改哪里
面对这 4,310 万次请求,我会先按网址汇总请求量,看看消耗集中在哪里。同时从不同目录、语言版本和页面类型中各取一些地址,免得只看访问最频繁的那一小批。
抽到一个地址后,我关心的是它现在返回什么、内容还值不值得保留,以及用户能从哪里走到它。商品目录和 sitemap 可以帮忙补充候选地址,但把它们列出来之后,仍然要检查页面和站内路径。不能因为某个地址在 sitemap 里,就认为用户在网站上也容易找到它。
不同的核查结果,会对应不同的处理方向。
| 核查后看到的情况 | 我会怎么处理 |
|---|---|
| 页面仍有价值,也能沿正常站内链接找到,只是没有出现在爬取清单中 | 回查爬取范围、过滤规则和网址匹配,先补齐统计,再判断是否有网站问题。 |
| 页面仍有价值,进一步检查后确认缺少相关的站内入口 | 从合适的分类、专题或关联商品处补上链接,让用户确实有路可走,并重新验证能否发现。 |
| 地址对应已下架内容、旧版页面或跳转 | 根据是否有替代内容决定保留、跳转或移除,并核对现有响应;不为了进入清单,把所有旧地址重新挂回站内。 |
这也是我不会直接给这一组地址贴上“孤岛页面”标签的原因。只有查过站内链接,才知道它们是不是缺少入口。若只是爬取任务排除了某个目录,补内链就没有解决真正的问题。
抽样能帮我找到下一步该查的地方,但不能直接拿样本里的比例乘以 4,310 万,估算全站浪费了多少请求。若要解释八九月的请求,还得查当时的商品状态和页面响应。今天已经下架,不等于被访问时也没有价值。只有把这些时间关系核实后,才适合将分类规则用于完整日志,统计涉及多少独立网址、多少请求;暂时分不清的地址,继续保留为待查。
比例变好看,也可能只是清单变完整了
假如补跑了一次站内爬取,找回一批原来没列出的页面,再拿同一份历史日志来匹配,清单内的请求占比就可能上升。Googlebot 连一次新请求都没有发出,比例也会变。
所以我不会把“让 3.2% 提高到多少”直接当作修复目标。清单补完整,说明我更清楚这些请求去了哪里;网站有没有改善,需要另外看。
如果最后发现的是重要商品缺少入口,我会在修改前保存一份要修的页面名单,记录它们的上线或内容更新时间。修改后,继续跟踪这组页面,比较同样长的时间窗口里,多少地址收到了成功的正文抓取,更新到抓取之间隔了多久。到观察结束还没抓取的页面,要标成“仍在等待”,不能只对已经抓取的页面计算等待时间。
这期间新增的商品可以另外跟踪,不要不断换进原来的名单。固定名单能减少比较对象变化的干扰,却不能单凭前后差异证明补链接有效,还要核对页面的更新情况和同期全站抓取变化。如果全站都抓得更快了,就不能把这组页面的改善全算在补链接上。
抓取之后有没有收录、有没有带来搜索点击,也需要接着看,不能用请求记录替它们作答。
我会先从清单外的干净网址里抽样,分清是清单漏记、页面缺少入口,还是旧地址仍在被访问,再决定下一项任务交给谁。仅凭那个 3.2%,还开不出一张可靠的修改单。